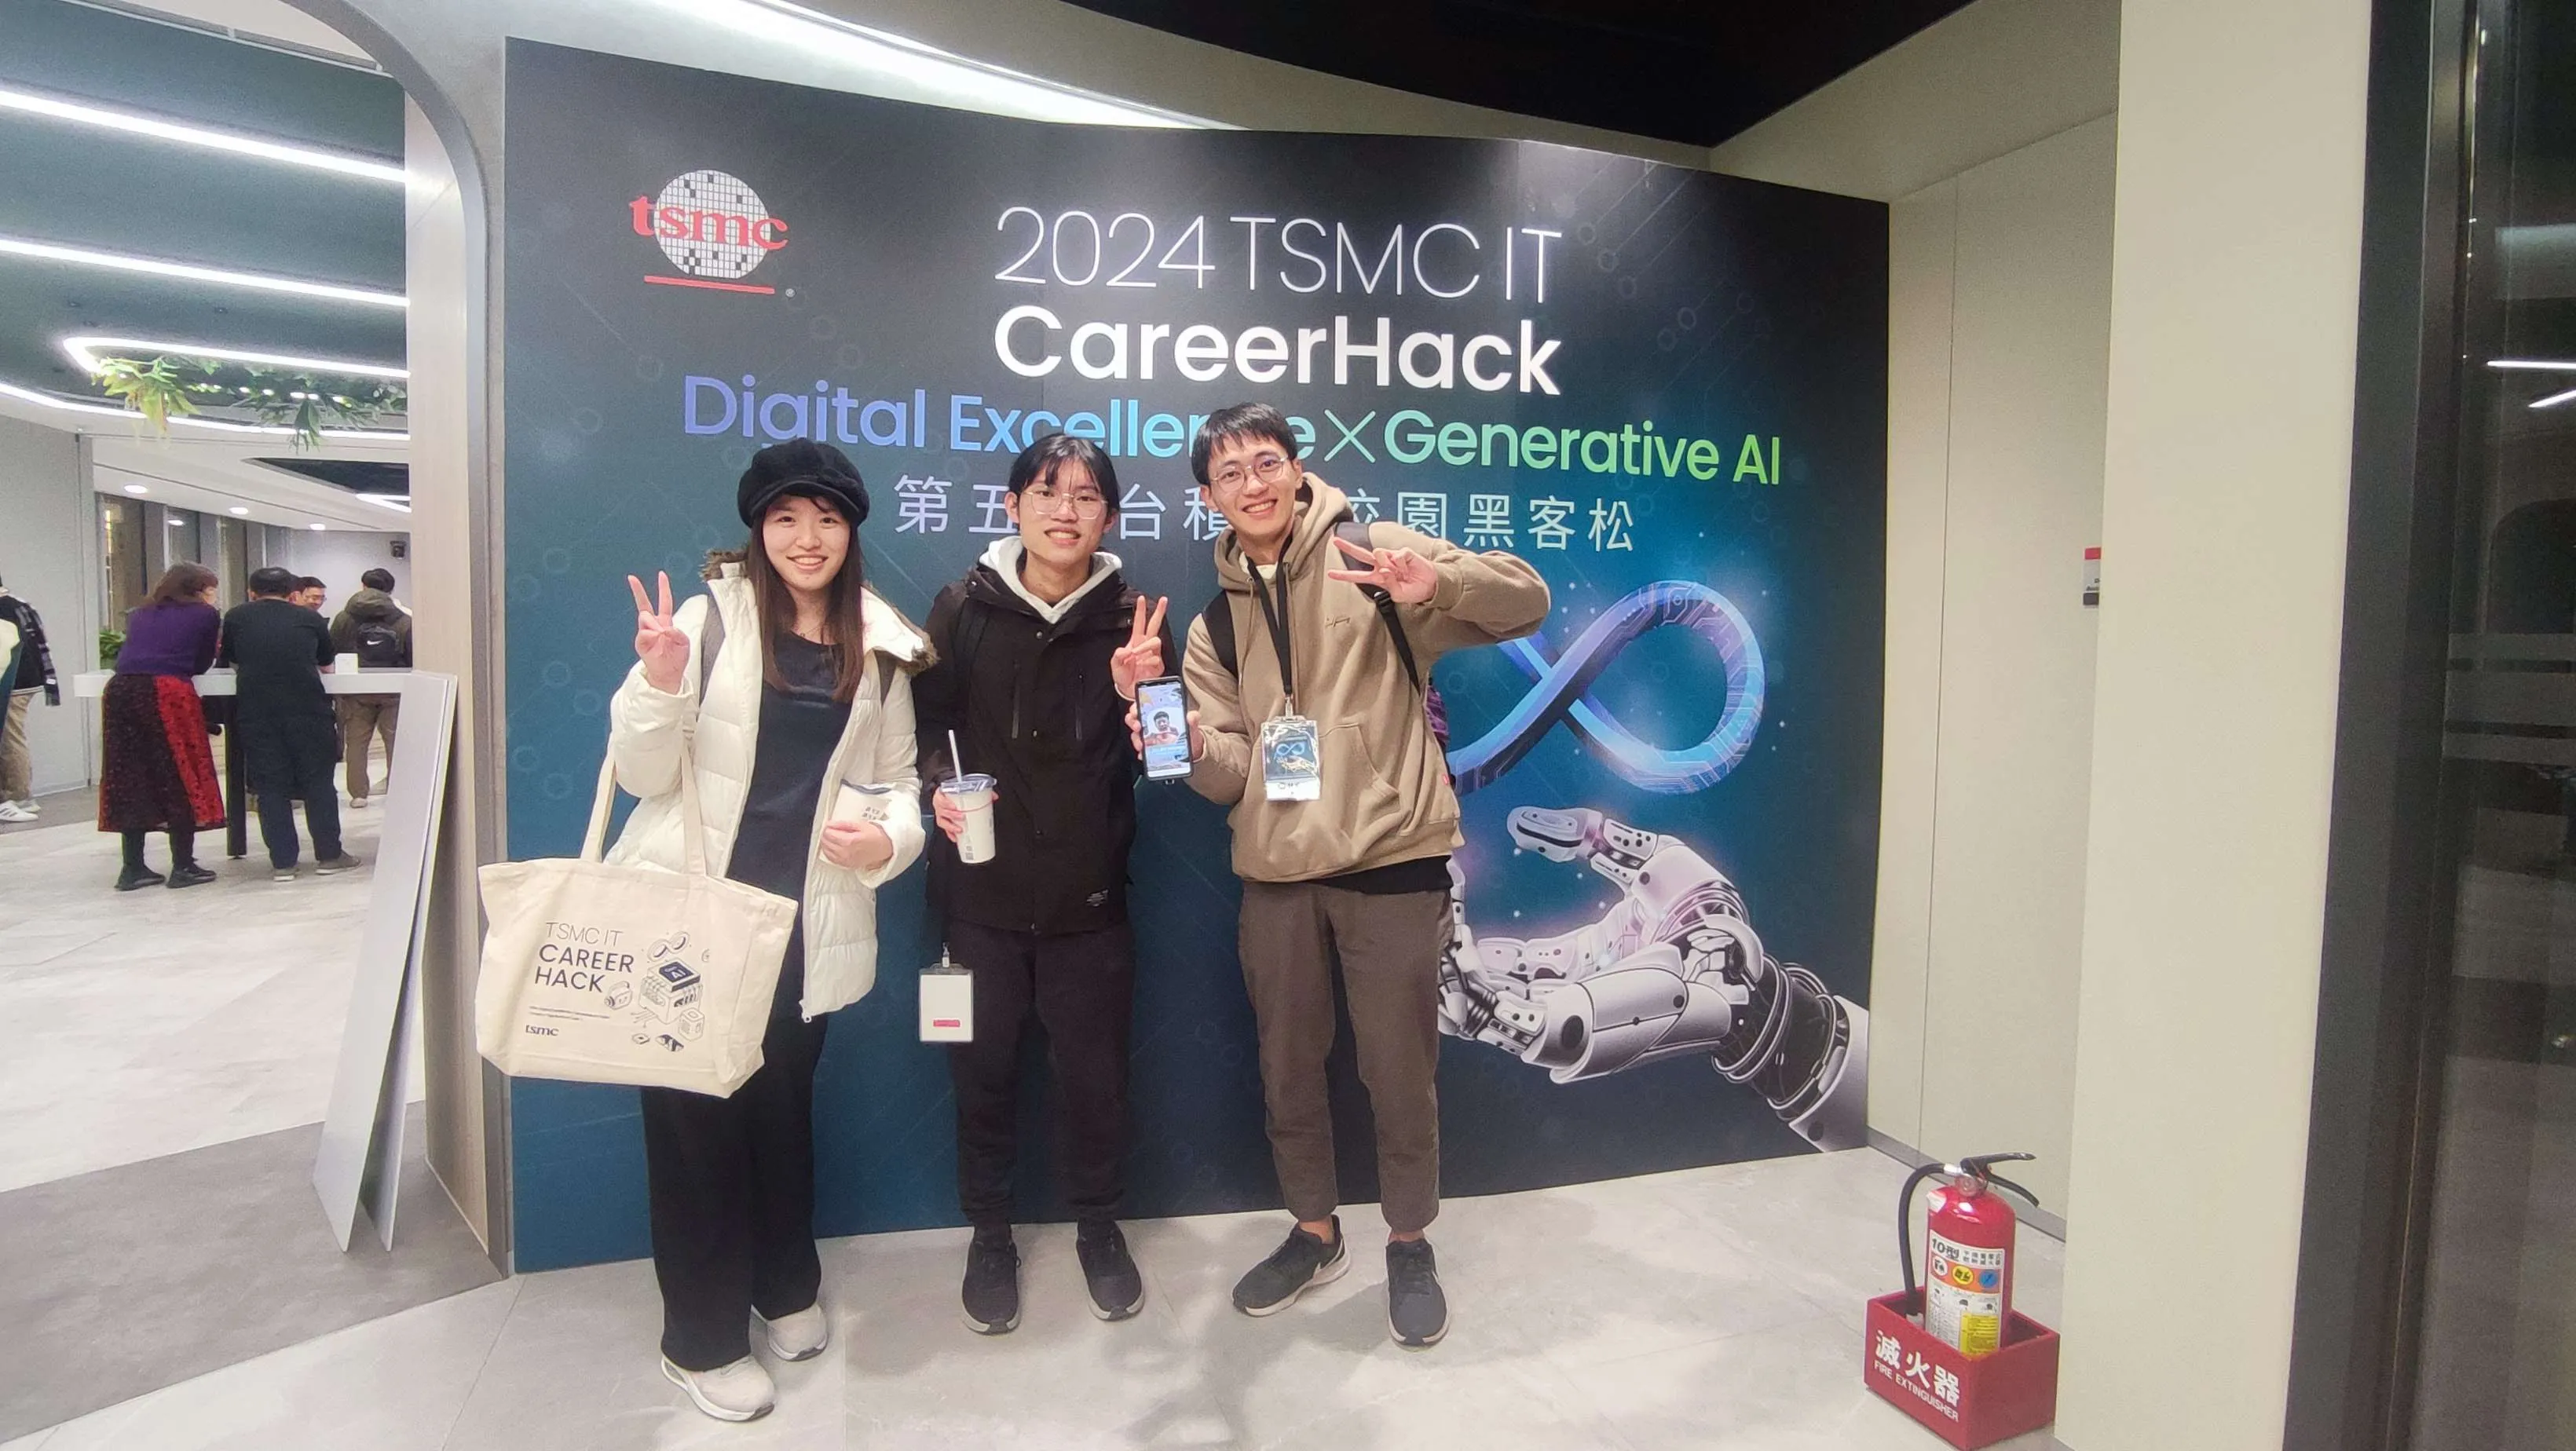
2024 TSMC IT CareerHack 校園黑客松
第一次接觸 LLM,簡單地對 LLaVA 做了 LoRA finetune。雖然沒得獎,但還是很棒的經驗。
參賽緣由#
這次是被晨鍾邀請去參加 台積電 2024 校園黑客松。乘著梅竹黑客松拿到不錯成績的氣勢,想說看能不能再拿一個獎,就報名了這場比賽。
在看主題的時候,因為我跟禾堃在讀書會已經看過不少 CV(Computer Vision)相關的論文跟實作,所以就決定選「AI 看圖說故事」這個題目。
初賽#
要真的在 1/26、1/27 到他們台北辦公室打決賽,得先參加線上初賽。基本上就是考程式能力,語言可以從 C++、Python、Java 之類的裡面選。題目相對簡單,我抽到的就是貪心跟一些很基礎的題目,聽朋友說也有樹相關的題目。但真的滿基礎的,有種回到大一程式設計通宵的感覺。
總之我個人覺得初賽跟決賽關聯性很低,用這個機制來篩選讓我還滿意外的。(聽說有一百多隊報名,最後選出 24 隊)
決賽#
後來收到進決賽的通知,同時也拿到題目跟黑客松的時程資訊,我們就開始準備了。
題目:AI 看圖說故事#
主辦方提供了一份包含工地安全帽影像與 GPT 對話結果的資料集,還有一個用 LoRA 預訓練過的 LLaVA 模型。我們的任務是用這些資訊做出一套系統,能夠讀入影像並回答以下這些問題:
{
"Q1": "Is there any people not wearing a helmets? Please answer with true or false.",
"Q2": "How many people are there in the image? Please give a single integer answer.",
"Q3": "How many people are there and wear a helmets in the image? Please give a single integer answer.",
"Q4": "How many people are there and not wear a helmets in the image? Please give a single integer answer.",
"Q5": "Tell the color of the helmets that people wear in the image from this list: red, yellow, blue, white, green, orange, black.The answer may be more than one color.If there is no one wear a helmets, please answer None as response. ",
"Q6": "What is the warning message shown in the image? Just give me the warning sentence.",
"Q7": "Is there anyone violating the warning message describe in the image?  Please answer with true or false."
}最後會用主辦方提供的 private test set 來評分,總分有 70% 來自上述輸出的正確率,只有 30% 是看現場 demo 的表現。
這個計分機制跟我之前參加的梅竹黑客松完全不同,而且有些地方讓我覺得滿困惑的:private set 只有 107 張圖,卻給了我們將近 1.5 小時產生結果。如果有人真的想這麼做,把答案全部手動標註出來並非不可能。他們要怎麼確保沒有隊伍是自己手動填答案的?雖然現場有人在監督、也有警告不要作弊,但我還是覺得有點不太合理。
在 GCP(Google Cloud Platform)上遇到的問題#
這次他們也請 Google Cloud 提供運算資源給我們用,但使用體驗其實不太順利。
我們在嘗試 finetune instruct-BLIP 的時候,有一次把 RAM 撐爆,導致整台 instance 掛掉。比賽前我們的 instance 也曾莫名其妙壞掉,還收到一封信問我們是不是做了什麼把它弄壞,但我們完全不知道發生什麼事,也沒做什麼特別的操作。
具體來說,他們提供的 instance 壞了兩次:
- 第一次是黑客松後兩天,我突然收到主辦方的信,提醒我們 instance 掛了,問我們是不是跑了什麼指令。但我們並沒有做任何特別的操作,到現在還是不知道那台機器發生什麼事。
- 第二次是比賽前一天,我們想把 instruct-BLIP 載到 instance 上 finetune,看起來是把硬碟塞爆了,整台 instance 就掛了。
除了 instance 之外,他們提供的 bucket 也有問題:比賽前跟比賽中,我跟禾堃從 instance 上傳大檔案到 bucket 時都遇到 permission error。一直到當天 Google Cloud 團隊來現場支援,才發現問題是上傳會額外向 bucket 要求一個 get 指令,而我們的 instance 一開始似乎沒有這個權限,才導致這個狀況。
不過我一定要說,工作人員真的非常主動,基本上有問題馬上就處理。在修 bucket 問題的時候我真的能感受到他們的熱情,也給了我不小的壓力(被六七個人圍著的壓力不是開玩笑的…)。總之真的很感謝他們的幫忙!
結果#
雖然比賽期間遇到不少狀況:像是我拖了很久的腸胃炎、Google 實習申請被拒,加上第二天還少了一位隊友(他去日本了😢),多多少少影響了我們這兩天的表現,所以最後做出來的東西遠低於我的預期。但我覺得沒表現好的更重要原因,其實是「太晚開始」跟「誤解題目」。
太晚開始#
工作坊結束之後,我們基本上只做了簡單的論文回顧,測試了 LLaVA、BLIP、Flamingo 三種架構。我們很晚才發現主辦方提供的資源根本不夠跑 BLIP 跟 Flamingo,所以花了很多時間在對最終結果沒什麼幫助的事情上。再加上那幾天我的身體狀況,我只做了簡單的資料分析,連他們的範例程式都沒有先跑過一遍去 finetune LLaVA——這件事一直拖到比賽當天才做,所以我覺得我們真的開始得太晚。只靠比賽那兩天,能產出的大概也就這樣了。
誤解題目#
第一次看到題目時,我們想的是「前面幾題真的需要生成式模型嗎?」這些題目其實用我們學過的 CV 模型就能解得不錯,為什麼需要生成式模型呢?(當然像 Q7 這種需要邏輯推理的題目,我們也認為是必要的。)所以我們寫信問主辦方能不能用電腦視覺模型來回答,他們的回覆是「不建議用專門的模型逐題回答,因為像第 7 題這種問題需要更泛化的能力」。雖然我們覺得這沒有正面回答我們的問題,但理解成他們「不希望」我們使用非生成式模型。結果比賽當天,我們看到很多隊伍把 CV 模型的輸出跟問題組合成新的 prompt,再丟給 LLM 生成結果。除了佩服其他隊伍的創意之外,也很後悔誤解了主辦方的意思,沒有往「影像辨識結合 LLM」的方向去想。這是這次比賽最可惜的地方。
心得#
這次比賽讓我覺得可惜,是因為我們並沒有全力以赴。雖然有收到評審的稱讚:「好可惜!你們在邊緣(第四名)!而且你們才大三而已,這麼年輕,其他隊伍都是研究生耶!」——我想這大概是安慰的成分居多,但聽到還是會讓心情好一點,真的很神奇。不過這次經驗對我來說,是非常好的機會去摸索整個 LLM 的架構,也有機會實際用 deepspeed 去 finetune 一個模型,這跟我後來實驗室教授交給我的任務完全接得上。所以我現在轉念了,覺得這次比賽能有這些收穫就已經很足夠了,剩下的就留給未來的自己去努力。希望未來的我回頭看這次參賽,會覺得自己成長了很多!